Choisir les tâches qui méritent une automatisation
Une intelligence artificielle en entreprise ne doit pas être introduite parce qu’elle est à la mode. Elle devient pertinente lorsqu’elle répond à une tâche identifiable, avec un objectif mesurable, des données accessibles et un niveau de risque acceptable. La première question n’est donc pas « quel outil choisir? », mais « quelle activité peut être améliorée sans fragiliser l’organisation? ».
Points complémentaires sur Choisir les tâches qui méritent une automatisation
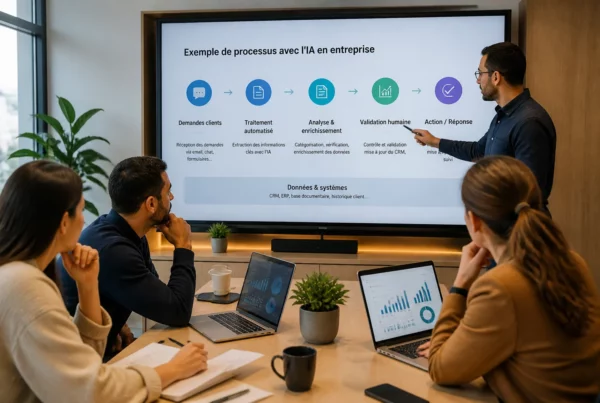
Les tâches les plus adaptées sont souvent répétitives, documentées et vérifiables. Un assistant peut, par exemple, classer des demandes entrantes, rechercher une information dans une base interne, préparer une synthèse ou proposer une première réponse. La validation finale reste humaine lorsque le contenu engage le client, les finances, la conformité ou la réputation de l’entreprise.
Décision selon les besoins du produit
À l’inverse, une automatisation complète est risquée lorsque la tâche repose sur des informations incomplètes, une interprétation juridique, une négociation ou une décision difficile à justifier. L’IA peut alors préparer des éléments, mais ne doit pas devenir l’unique décideur. Cette distinction évite de confondre gain de temps et transfert irréfléchi de responsabilité.
Vérifier la qualité des données avant l’IA
La qualité des réponses dépend largement de la qualité du contexte fourni au système. Des documents contradictoires, obsolètes ou mal classés peuvent produire une réponse formulée avec assurance mais fondée sur une mauvaise source. Avant toute intégration IA, il faut donc identifier les données utilisées, leur propriétaire, leur date de mise à jour et les conditions d’accès.
Classer les données selon leur sensibilité
Une classification simple aide à définir les règles d’usage. Les contenus publics peuvent être traités plus librement, tandis que les informations internes doivent rester accessibles uniquement à certains rôles. Les données confidentielles ou personnelles exigent des précautions supplémentaires: minimisation, limitation des accès, conservation maîtrisée et vérification du cadre contractuel du service utilisé.
Repères complémentaires sur Classer les données selon leur sensibilité
Cette classification doit être reliée aux flux réels. Une donnée peut être protégée dans une base mais devenir exposée lorsqu’elle est copiée dans un prompt, un export ou un historique de conversation. Le contrôle doit donc couvrir la collecte, la transmission, le traitement, la réponse générée et les journaux conservés.
Limiter les sources et le contexte transmis
Un assistant interne ne devrait pas interroger indistinctement tous les fichiers disponibles. Il vaut mieux définir des sources autorisées, segmenter les espaces documentaires et récupérer uniquement les passages nécessaires à la demande. Cette approche réduit le risque de divulgation et facilite la vérification de la réponse.
Risques et limites à considérer
Dans un système de récupération de contexte, l’architecture peut séparer l’interface, la couche d’accès, le moteur de recherche documentaire, le modèle IA et l’application métier. Chaque couche doit appliquer ses propres règles. La documentation d’un fournisseur comme la documentation IA peut compléter ce cadrage sur les appels d’API, les outils, les limites et les pratiques de déploiement, sans remplacer l’analyse du contexte métier.
Sécuriser l’intégration dans le système métier
Une IA isolée dans une interface de conversation n’a pas le même niveau de risque qu’un assistant capable de lire un CRM, de modifier une fiche ou de déclencher un message. Dès qu’une intégration donne accès à une application, il faut distinguer la génération d’une proposition et l’exécution d’une action. Cette séparation constitue un contrôle technique simple mais déterminant.
Contrôler les accès et les actions
Chaque utilisateur doit conserver ses propres droits. L’assistant ne doit pas contourner les permissions existantes ni utiliser un compte partagé plus puissant que nécessaire. Les actions sensibles peuvent être soumises à une confirmation explicite, à une double validation ou à un périmètre limité: lecture seule au départ, puis écriture contrôlée après observation.
Risques et limites à considérer
Les intégrations par API doivent également prévoir la gestion des erreurs, les limites d’appels et les interruptions de service. Une requête répétée ou mal interprétée peut provoquer des doublons, une surcharge ou une action non souhaitée. Des mécanismes d’idempotence, de simulation et d’annulation sont utiles lorsque le système modifie des données.
Journaliser pour pouvoir expliquer
Sans journal, il devient difficile de comprendre pourquoi une réponse a été produite ou pourquoi une action a été déclenchée. Il est utile de conserver, selon les règles de confidentialité applicables, l’identité du demandeur, la source consultée, la version de la consigne, le résultat, la validation humaine et l’éventuelle action exécutée.
Risques et limites à considérer
Les journaux servent à la sécurité, mais aussi à l’amélioration. Ils permettent d’identifier les questions mal comprises, les sources insuffisantes, les erreurs récurrentes et les scénarios qui devraient être redirigés vers un collaborateur. Ils doivent toutefois être protégés eux-mêmes, car ils peuvent contenir les informations transmises au système.

Organiser le contrôle humain
Le contrôle humain ne consiste pas à demander à un collaborateur de relire mécaniquement chaque phrase. Il faut définir les situations dans lesquelles l’intervention est obligatoire. Une réponse informative à faible enjeu peut être publiée après un contrôle par échantillonnage, tandis qu’une recommandation commerciale, financière ou contractuelle doit rester soumise à une validation explicite.
Points complémentaires sur Organiser le contrôle humain
Un bon dispositif prévoit aussi une possibilité d’escalade. Lorsque la confiance est faible, que les données sont absentes ou que la demande sort du périmètre défini, l’assistant doit le signaler et transmettre le dossier. Cette règle est plus fiable qu’une consigne générale demandant simplement à l’IA d’être prudente.
Risques et limites à considérer
La supervision doit être attribuée à des personnes identifiées. Elles vérifient la pertinence des réponses, remontent les cas limites et participent à l’évolution des règles. La formation des utilisateurs compte autant que la configuration technique: un collaborateur doit savoir quelles informations ne pas transmettre et comment signaler une sortie incorrecte.
Pour approfondir la réflexion sur les applications possibles, l’article consacré aux usages de l’IA peut aider à distinguer les assistants, l’analyse documentaire et l’automatisation opérationnelle.
Déployer progressivement sans perdre la maîtrise
Un déploiement maîtrisé commence par un périmètre réduit. Il permet de tester les données, les accès, la qualité des réponses et l’acceptation par les équipes avant de connecter davantage d’outils. Le projet doit être documenté afin que les décisions techniques restent compréhensibles lorsque le système évolue.
Cadrer le besoin et le risque
La première étape consiste à décrire la tâche, les utilisateurs, les données impliquées, la sortie attendue et les conséquences d’une erreur. Il faut ensuite décider si l’IA conseille, prépare, classe ou agit. Cette distinction détermine le niveau de validation, les droits techniques et les tests nécessaires.
Tester sur un périmètre limité
Le prototype doit utiliser des exemples représentatifs, y compris des demandes ambiguës, incomplètes ou contradictoires. Les réponses sont évaluées par des personnes qui connaissent le métier. On mesure notamment les corrections nécessaires, les demandes transférées à un humain, les erreurs de classement et le temps réellement économisé.
Préparer la mise en production
Avant la mise en production, il faut prévoir les rôles, les accès, les alertes, les procédures d’arrêt et les responsables de suivi. La solution doit également être testée lorsque l’API est indisponible, lorsque la donnée attendue manque ou lorsqu’un utilisateur tente une action non autorisée. Une solution qui fonctionne uniquement dans le scénario idéal n’est pas prête.
Risques et limites à considérer
- Définir un cas d’usage et un niveau de risque précis.
- Limiter les données, utilisateurs et actions accessibles.
- Évaluer les réponses avec des exemples métier variés.
- Ajouter validation, journalisation et procédure d’arrêt.
- Suivre les résultats puis élargir progressivement le périmètre.
Maintenir une solution IA dans le temps
Une solution IA n’est pas un livrable figé. Les documents changent, les processus évoluent, les accès sont modifiés et les fournisseurs font évoluer leurs modèles ou leurs interfaces. Une maintenance régulière est donc nécessaire pour éviter qu’un assistant devienne progressivement moins pertinent ou qu’une intégration cesse de respecter les règles de sécurité.
Points complémentaires sur Maintenir une solution IA dans le temps
La maintenance couvre les sources documentaires, les instructions, les permissions, les connecteurs, les tests et les journaux. Une revue périodique peut repérer les réponses qui nécessitent souvent une correction, les documents jamais consultés, les actions bloquées ou les demandes qui devraient être reformulées.
Risques et limites à considérer
Il faut aussi surveiller les contraintes opérationnelles: volume de requêtes, temps de réponse, coûts d’usage, dépendance à un fournisseur et disponibilité des services connectés. L’objectif n’est pas de promettre une précision parfaite, mais de connaître les limites du système et de prévoir une solution de repli lorsque le service est indisponible.
Le rôle d’un partenaire digital
Pour les entreprises desservies à Sousse, WEB MEDIA Agence web Tunisie peut aborder ce type de projet comme un sujet d’intégration et d’évolution digitale, et non comme l’ajout isolé d’un chatbot. L’analyse porte d’abord sur les objectifs, les tâches, les données et les outils existants, puis sur les fonctionnalités réellement utiles.
Mise en œuvre et intégration
WEB MEDIA Agence web Tunisie relie ainsi son accompagnement en intelligence artificielle entreprise à une démarche structurée: compréhension du besoin, définition des fonctionnalités, conception lorsque nécessaire, intégration, tests, mise en production, maintenance et évolution. Cette approche est particulièrement utile lorsque l’assistant doit dialoguer avec un site, une plateforme ou un outil métier.
Risques et limites à considérer
Le périmètre, les technologies, les intégrations et le niveau de sécurité dépendent de chaque projet. Une entreprise peut commencer par un assistant documentaire ou une automatisation limitée, puis faire évoluer le dispositif après vérification des résultats. À Sousse, cette progression permet de construire un usage concret sans engager immédiatement toutes les données et tous les processus.
Mesurer les résultats sans se limiter au volume
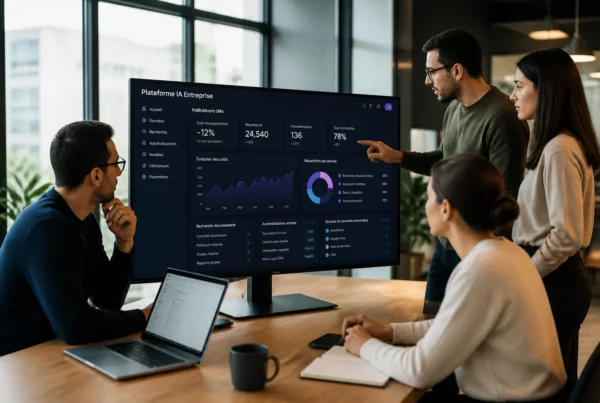
Le nombre de requêtes traitées ne suffit pas à juger la valeur d’une IA. Un assistant très utilisé mais souvent corrigé peut créer une charge supplémentaire. Les indicateurs doivent combiner qualité, sécurité, adoption et efficacité opérationnelle.
- Temps de traitement avant et après l’intégration.
- Part des réponses corrigées ou rejetées.
- Nombre de demandes transférées à un humain.
- Erreurs d’accès, incidents et actions bloquées.
- Coût d’usage et disponibilité du service.
Performances et critères de mesure
Ces indicateurs doivent être interprétés avec le contexte. Une hausse des escalades peut signaler un mauvais paramétrage, mais aussi une supervision saine. De même, une baisse du temps de traitement ne doit pas justifier une dégradation de la qualité ou une exposition excessive des données.
FAQ
Quelles tâches confier en priorité à une IA?
Commencez par des tâches répétitives, documentées et vérifiables, comme la recherche d’information, la synthèse ou le classement.
Les données internes peuvent-elles être utilisées avec une IA?
Oui, sous réserve de règles précises sur les accès, les sources autorisées, la transmission, la conservation et les conditions du fournisseur.
Faut-il toujours valider les réponses générées?
La validation dépend du risque. Elle doit être obligatoire pour les décisions sensibles et organisée par échantillonnage pour les usages moins critiques.
Comment éviter qu’un assistant agisse à la place d’un utilisateur?
Conservez les permissions existantes, séparez proposition et exécution, puis imposez une confirmation pour les actions sensibles.
Pourquoi prévoir une maintenance spécifique?
Les sources, processus, connecteurs et modèles évoluent. Des tests et revues régulières évitent la dérive des réponses et des règles.
Une entreprise doit-elle commencer par un projet complexe?
Non. Un périmètre limité permet de vérifier la valeur, la sécurité et l’acceptation avant d’élargir l’intégration.
Mise en œuvre et intégration
Une intégration raisonnée de l’IA repose moins sur l’effet de nouveauté que sur la précision du cadrage. En séparant les données, les droits, les propositions et les actions, l’entreprise conserve une capacité de contrôle réelle. Le projet peut alors évoluer par étapes, avec des résultats observables et des règles révisables.