En 2026, intégrer l’intelligence artificielle à un site web ne consiste plus à ajouter un chatbot sur une page d’accueil. Le véritable enjeu est de relier une interface, des données fiables et des actions métier mesurables. Une solution bien conçue peut réduire les tâches répétitives, accélérer la réponse commerciale et améliorer la pertinence du parcours utilisateur.
Pour une entreprise implantée à Tunis, le développement web basé doit donc partir d’un problème concret: qualifier davantage de demandes, traiter plus vite des documents, recommander le bon produit ou donner aux équipes un accès immédiat à l’information. WEB MEDIA Agence web Tunisie accompagne cette réflexion sur le développement web basé sur l’IA à Tunis, avec une approche qui relie stratégie, conception, développement et évolution du projet.
L’IA ne garantit toutefois ni croissance automatique ni retour sur investissement instantané. Sa valeur dépend de la qualité des données, de la pertinence du scénario, de l’intégration aux outils existants et de la capacité à contrôler les résultats. Une démonstration peut sembler convaincante tout en devenant imprécise dès qu’elle rencontre un document incomplet, une règle commerciale exceptionnelle ou une information qui n’est plus à jour.
De la tendance à la rentabilité
Un projet web augmenté par l’IA devient rentable lorsqu’il améliore une étape identifiable du parcours client ou du fonctionnement interne. Il faut pouvoir comparer une situation de départ avec un indicateur après déploiement: délai de réponse, volume de leads qualifiés, temps administratif, taux de conversion ou nombre de dossiers traités.
Les leviers de performance commerciale
Le premier levier concerne l’assistance à la vente. Un agent connecté au catalogue, aux règles commerciales et aux disponibilités peut répondre à des questions précises, proposer une sélection et transmettre une demande qualifiée. Il ne remplace pas nécessairement le commercial: il prépare l’échange et réduit les délais de prise en charge.
Un tel agent ne se limite pas à générer du texte. Il peut appeler des fonctions métier définies par l’application, par exemple rechercher un produit, vérifier une disponibilité, créer une demande ou préparer une tâche dans le CRM. Chaque fonction doit avoir des paramètres contrôlés, un périmètre limité et une réponse vérifiable. L’agent propose alors une action; le système décide si elle peut être exécutée.
Le deuxième levier est l’automatisation des processus. La collecte d’un formulaire, la lecture d’une facture, la classification d’un ticket ou la relance d’un prospect peuvent être orchestrées par des règles et des appels d’API. Le gain réel ne vient pas du modèle seul, mais de la suppression des ressaisies et de la circulation plus rapide de l’information.
Il est important de distinguer trois usages souvent confondus. La génération produit un texte, une image ou une synthèse; la prédiction estime une probabilité ou une catégorie à partir de données; l’exécution déclenche une action dans un système métier. Les deux premiers usages peuvent assister un collaborateur, tandis que le troisième exige des permissions, des contrôles et parfois une validation explicite.
Le troisième levier repose sur l’exploitation des données client. Une connexion contrôlée au CRM ou à l’ERP permet de tenir compte du statut d’un compte, de l’historique d’achat ou d’une demande en cours. Les droits d’accès doivent être appliqués côté serveur: une interface ne doit jamais exposer une donnée simplement parce qu’un utilisateur formule une instruction habile.
Enfin, la personnalisation peut adapter une recommandation, un contenu ou une étape du parcours. Elle doit rester explicable et réversible. Une offre affichée à un visiteur doit répondre à une logique commerciale compréhensible, et non à une décision impossible à auditer. Lorsque les signaux sont faibles ou que le consentement nécessaire manque, le parcours par défaut doit rester cohérent plutôt que de forcer une personnalisation artificielle.
- Qualifier les demandes avant leur traitement humain.
- Réduire les tâches de saisie et de recherche.
- Accélérer l’accès aux informations produits ou contractuelles.
- Personnaliser sans perdre la cohérence de la marque.
- Suivre chaque action dans un outil métier.
Architecture, sécurité et maîtrise des coûts
Une architecture web IA fiable sépare généralement l’interface, la logique applicative, les connecteurs, les données documentaires et le modèle utilisé. Cette séparation facilite les tests, permet de remplacer un fournisseur et limite les conséquences d’une erreur de génération.
La chaîne complète doit être comprise avant le développement: le site recueille la demande, l’API applique les règles et les permissions, le modèle interprète ou formule une réponse, la base documentaire apporte le contexte, puis le système métier fournit ou reçoit les données nécessaires. Une panne, une donnée obsolète ou une permission mal configurée peut donc dégrader le résultat à un autre endroit que l’interface visible.

RAG et qualité des données
Le RAG, ou génération augmentée par récupération, consiste à rechercher des passages pertinents dans une base documentaire avant de demander une réponse au modèle. Pour être utile, ce mécanisme doit gérer les versions, les droits d’accès, les documents obsolètes et la citation des sources. Sans cette couche, un assistant peut produire une réponse plausible mais sans fondement.
La recherche documentaire la plus fiable combine généralement recherche sémantique et filtres métier. La première rapproche une question et un passage par leur sens; les seconds limitent les résultats selon le produit, la langue, la date, le service, le rôle de l’utilisateur ou le statut du document. Cette combinaison évite de retenir un texte proche mais applicable à une autre agence, une ancienne offre ou un autre type de contrat.
Le périmètre documentaire doit être défini avant le choix technique. Catalogue, FAQ, procédures, contrats et données CRM n’ont ni la même fréquence de mise à jour ni les mêmes exigences de confidentialité. Les documents doivent être nettoyés, découpés de façon cohérente et associés à des métadonnées permettant de filtrer les résultats. Une réponse devrait pouvoir indiquer les sources utilisées ou signaler qu’aucune source suffisamment fiable n’a été trouvée.
La présence d’une source ne suffit cependant pas à garantir la justesse d’une réponse. Il faut vérifier que le passage récupéré est encore applicable, qu’il correspond au profil de l’utilisateur et qu’il contient réellement l’information demandée. Une réponse convaincante mais non traçable doit être traitée comme une hypothèse, non comme une instruction opérationnelle.
Les bonnes pratiques générales de performance, d’accessibilité et d’expérience utilisateur restent indispensables. Les ressources de web.dev fournissent une documentation utile pour contrôler ces dimensions sur une interface moderne.
Contrôle humain et gouvernance
Une validation humaine est recommandée lorsqu’une action peut engager financièrement l’entreprise, modifier un dossier sensible, refuser un client ou envoyer une communication contractuelle. L’IA peut préparer une décision, mais le système doit distinguer clairement la suggestion, l’approbation et l’exécution.
Cette règle est particulièrement importante pour les agents capables d’appeler des fonctions métier. Une demande de remboursement, une modification de coordonnées, une suppression ou une relance massive ne devrait pas être exécutée uniquement parce que le modèle a interprété une conversation. Le workflow peut demander une confirmation, limiter le montant ou transmettre l’action à un collaborateur habilité.
La sécurité couvre aussi les tentatives de prompt injection, l’exfiltration de données et les permissions excessives accordées à un agent. Les instructions reçues depuis une page ou un document doivent être considérées comme des données, pas comme des règles prioritaires. Les journaux doivent conserver la demande, les sources consultées, l’action proposée et l’identité du validateur.
La journalisation doit également distinguer ce qui a été généré de ce qui a réellement été exécuté. Cette différence facilite l’analyse d’un incident, la recherche d’un doublon et la vérification du respect des rôles. Les permissions doivent être contrôlées côté serveur et testées avec plusieurs profils; masquer un bouton dans l’interface ne constitue pas une protection suffisante.
Le coût dépend du volume de requêtes, de la longueur des contextes, du stockage, de la fréquence des traitements et du niveau de supervision. Un modèle plus puissant n’est pas systématiquement le meilleur choix. Un modèle plus léger peut convenir à la classification, tandis qu’un autre sera réservé aux réponses complexes. Les coûts de connecteurs, de stockage, de contrôle humain et de maintenance doivent aussi être pris en compte.
La documentation officielle de Google Search Central peut compléter cette réflexion lorsqu’un projet utilise l’IA pour produire ou enrichir des contenus destinés à la visibilité organique. La génération ne dispense pas de contrôler l’utilité, l’exactitude et l’originalité des pages publiées.
Dix projets web IA à fort impact
Les projets suivants ne sont pas des fonctionnalités à empiler. Chacun répond à un problème différent et doit être évalué avec ses données disponibles, ses contraintes de sécurité et son indicateur de valeur.
Commerce et relation client
1. Agent de vente et d’upselling
Connecté au catalogue, aux stocks et aux règles de compatibilité, l’agent aide un client à choisir un produit complexe. Sa valeur se mesure au taux de demandes qualifiées, aux ventes assistées et au panier moyen, sans lui permettre d’inventer une disponibilité. Une fonction de consultation contrôlée doit fournir les informations actualisées avant toute recommandation.
2. Personnalisation du parcours e-commerce
Le site peut adapter une sélection ou un contenu selon le contexte de navigation et les préférences autorisées. Les règles doivent prévoir un affichage par défaut lorsque le signal est insuffisant, ainsi qu’un contrôle de la pression commerciale exercée. Il faut aussi pouvoir comparer le parcours personnalisé à un parcours standard afin de vérifier qu’il améliore réellement la conversion ou la qualification.
3. Recherche de produit par image
Un visiteur transmet une image afin de retrouver un article proche dans un catalogue. La qualité dépend de la richesse des visuels, des attributs produits et de la capacité à proposer une alternative lorsque la correspondance exacte n’existe pas. Le résultat doit présenter le degré de proximité comme une aide à la recherche, pas comme une identification certaine.
4. Assistant de support contextualisé
L’assistant récupère les procédures pertinentes et oriente vers un collaborateur lorsque la demande dépasse son périmètre. La traçabilité des sources et le transfert de l’historique évitent au client de répéter son problème. Un taux d’escalade élevé peut révéler un périmètre documentaire incomplet, mais un taux très faible peut aussi signaler que l’assistant retient à tort des demandes sensibles.
Processus internes et décision
5. Extraction de devis et factures
Un workflow d’IDP extrait les champs d’un document, vérifie leur cohérence et transmet les anomalies à un utilisateur. La validation reste nécessaire pour les montants, les coordonnées bancaires et les exceptions comptables. Les tests doivent couvrir des documents réels représentatifs, y compris les scans de qualité variable, les formats inhabituels et les champs absents.
6. Maintenance prédictive connectée
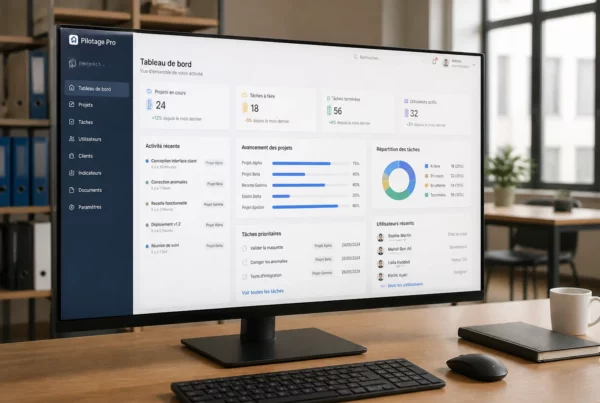
Un tableau de bord peut combiner données d’équipement, historiques d’intervention et alertes pour prioriser les actions. La pertinence dépend de la qualité des capteurs et de l’existence d’un processus réel de suivi après alerte. Une prédiction inutile si personne ne vérifie l’équipement ou ne planifie l’intervention ne crée pas de valeur opérationnelle.
7. Audit automatique de qualité web
Un pipeline peut contrôler des règles de code, des erreurs récurrentes, des éléments d’accessibilité et certains risques avant une mise en production. Il doit compléter les tests humains et automatisés, jamais les remplacer entièrement. Après une modification du modèle ou des règles, des tests de régression doivent confirmer que les contrôles existants restent interprétés correctement.
8. Scoring explicable pour le financement
Un système d’aide à la décision peut accélérer l’analyse d’un dossier, à condition d’expliquer les facteurs retenus et de respecter les règles applicables. Les décisions sensibles exigent une gouvernance, une possibilité de recours et une validation compétente. La qualité du score doit être suivie séparément de sa rapidité, car une décision plus rapide n’est pas nécessairement une meilleure décision.
9. CMS assisté pour le SEO
Un CMS peut suggérer des plans, repérer des pages proches, améliorer des titres ou signaler des informations manquantes. La supervision éditoriale reste indispensable pour éviter les contenus répétitifs, inexacts ou déconnectés de l’intention du lecteur. Chaque contenu publié doit pouvoir être relu, corrigé et retiré sans dépendre du modèle qui l’a généré.
10. Orchestration commerciale CRM et ERP
Une interface peut déclencher une relance, préparer un devis ou actualiser une fiche après validation. Les actions doivent être idempotentes, journalisées et protégées contre les doublons, notamment lorsqu’une API répond tardivement. Le système doit préciser si l’action a été proposée, acceptée, envoyée au connecteur ou confirmée par l’outil métier.
Une méthode de projet orientée ROI
La première étape consiste à formuler le problème en termes opérationnels. « Ajouter de l’IA » n’est pas un objectif; « réduire le temps de qualification des demandes » ou « retrouver une procédure fiable depuis le portail client » constitue une base testable. Le cadrage doit également préciser les utilisateurs concernés, les décisions autorisées et les situations où l’IA doit s’effacer.
Avant le prototype, il faut cartographier les données, leurs propriétaires, leur fréquence de mise à jour et leurs niveaux de sensibilité. Cette étape révèle souvent qu’un cas d’usage dépend d’un CRM incomplet, de documents contradictoires ou de règles non formalisées. Corriger ces dépendances peut être plus utile que d’ajouter immédiatement un modèle plus performant.
- Cartographier le parcours, les irritants et les utilisateurs concernés.
- Définir les données disponibles, leurs propriétaires et leurs niveaux de sensibilité.
- Choisir un cas d’usage limité avec un indicateur de référence.
- Construire un prototype connecté à des données représentatives.
- Tester les réponses, les permissions, les erreurs et les coûts.
- Déployer progressivement avec supervision et amélioration continue.
Le prototype doit être évalué sur des cas réels représentatifs, et non uniquement sur des exemples préparés pour la démonstration. Il faut inclure des demandes ambiguës, des documents incomplets, des utilisateurs aux rôles différents et des informations obsolètes. Les résultats doivent être relus selon une grille définie à l’avance: pertinence, exactitude, traçabilité, sécurité et capacité à escalader.
Cette démarche permet de comparer plusieurs options: fonctionnalité intégrée à un site existant, application web métier, assistant connecté au CRM ou plateforme complète. Une architecture de plateforme peut être pertinente lorsque plusieurs rôles, workflows et intégrations doivent évoluer ensemble.
Les indicateurs doivent être suivis séparément. La qualité mesure si la réponse ou l’action est correcte; la latence mesure le temps d’attente; le coût mesure la dépense par interaction ou par traitement; l’impact business mesure, par exemple, la conversion, la qualification ou le temps économisé. Un résultat rapide et peu coûteux n’est pas satisfaisant si les réponses sont mal sourcées ou si les équipes doivent tout reprendre.
WEB MEDIA Agence web Tunisie peut intervenir dans cette logique de projet, depuis la compréhension des objectifs jusqu’au développement, aux tests et à la maintenance évolutive. L’agence dispose également d’une expérience des projets web et digitaux depuis 2005, sans réduire son rôle à la seule création de pages.
À Tunis, une entreprise qui envisage un développement web avec intelligence artificielle gagne à commencer par un atelier de cadrage: données accessibles, actions autorisées, utilisateurs, indicateurs et risques. Cette étape évite de financer une démonstration séduisante mais inutilisable dans les opérations quotidiennes.
Le bon choix technologique est celui qui reste contrôlable lorsque le volume augmente, que les documents changent ou qu’un fournisseur de modèle évolue. Il faut prévoir la réversibilité des données, la surveillance des erreurs, la mise à jour des contenus et la possibilité de désactiver une automatisation. Après chaque changement de modèle, de prompt, de connecteur ou de source documentaire, des tests de régression doivent être relancés.
Pour les entreprises de Tunis, l’enjeu n’est donc pas de suivre chaque nouveauté, mais de sélectionner les cas où l’IA améliore réellement une conversion, un délai ou une décision. WEB MEDIA Agence web Tunisie peut aider à relier cette ambition à une architecture web exploitable et à une feuille de route progressive.
FAQ
Qu’est-ce que le développement web basé sur l’IA?
C’est la conception d’un site ou d’une application qui utilise des modèles d’IA pour assister, personnaliser, analyser ou automatiser certaines fonctions web.
Un chatbot suffit-il pour obtenir un bénéfice business?
Non. Un chatbot apporte de la valeur seulement s’il répond à un besoin précis, accède à des données fiables et transmet correctement les demandes aux équipes.
Comment éviter les réponses incorrectes d’un assistant IA?
Il faut limiter son périmètre, l’ancrer sur des sources contrôlées, afficher les références lorsque nécessaire et prévoir une escalade humaine. Des tests sur des cas réels permettent ensuite de mesurer les erreurs restantes.
Quelles données connecter à une solution web IA?
Les données utiles dépendent du cas d’usage: catalogue, procédures, CRM, ERP, tickets ou documents. Chaque connexion doit respecter les droits d’accès et la confidentialité.
Comment mesurer le retour sur investissement?
Comparez une situation de référence avec les résultats après déploiement: temps de traitement, conversion, qualification, coût par interaction ou taux d’erreur. La qualité, la latence et l’impact business doivent être analysés séparément.
Faut-il développer une solution entièrement sur mesure?
Pas toujours. Une intégration existante peut suffire pour un besoin simple, tandis qu’une application sur mesure devient pertinente lorsque les workflows et les données métier sont spécifiques.